别被FP8算力忽悠!AI算力服务器选型,看懂这3个核心指标
点击蓝字 关注我们 采购AI服务器,很多技术负责人第一眼就盯着FP8浮点算力。数字越高,越觉得硬件性能越强。但大量落地项目反复验证:单纯追逐峰值算力,往往换来 GPU 低利用率与预算浪费。 算力采购的本质,是采购稳定可兑…
点击蓝字 关注我们
采购AI服务器,很多技术负责人第一眼就盯着FP8浮点算力。数字越高,越觉得硬件性能越强。但大量落地项目反复验证:单纯追逐峰值算力,往往换来 GPU 低利用率与预算浪费。算力采购的本质,是采购稳定可兑现的有效算力。本文跳出参数营销,拆解选型真正该关注的核心要素。
很多企业采购AI服务器,第一眼就盯着宣传页上FP8浮点算力,数字越大越心动。但项目落地之后才发现:纸面算力拉满,实际跑模型时GPU利用率长期不足20%,预算花出去,业务跑不动。这是当下AI算力采购最普遍的认知误区。
算力峰值只是理论天花板,企业真正要采购的,是可稳定兑现的有效算力。决定有效算力的,从来不是单看芯片浮点值,核心看三样:HBM显存容量、HBM带宽、卡间互联能力。
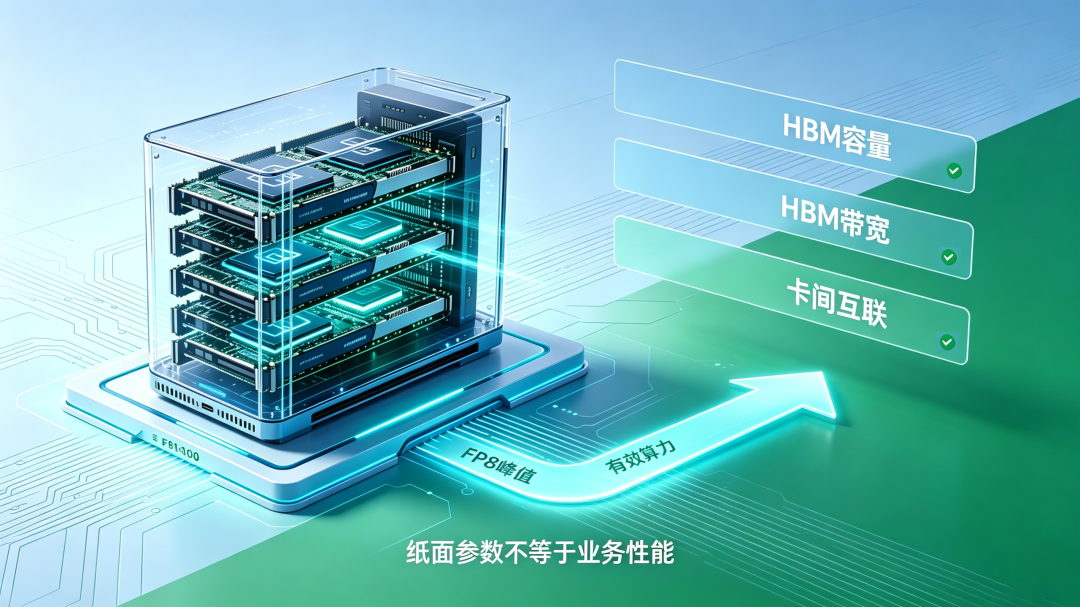
先说HBM,这是当前算力系统真正的瓶颈。大模型训练、微调、推理,本质是海量权重、激活值在内存与芯片之间反复搬运。很多项目算力充足,但显存容量不够,模型根本无法完整载入,只能切片、量化,精度受损;带宽不足,GPU大部分时间都在等待数据,算力空转。当前新一代AI整机物料成本结构已经发生反转,HBM+DRAM占整机成本六成以上,GPU芯片本身不再是最贵部件。内存墙,才是制约大模型落地的底层枷锁。
第二是卡间互联。不少客户直接采购多卡服务器,忽略互联规格。单机内卡间通信如果带宽不足,分布式并行训练时,大量算力消耗在数据同步上。8卡服务器,不是插上8张卡就等于8倍算力。尤其是做全量微调、预训练场景,互联一旦成为短板,集群效率直接腰斩。
第三,负载匹配。训练和推理对硬件诉求完全不同。训练场景优先显存容量、高速互联;推理场景更看重显存带宽、并发吞吐。很多企业犯的错,是直接拿高配训练服务器跑推理业务,硬件严重过剩,TCO居高不下。
舜源科技在服务申通快递、上海联通等算力项目时,坚持负载先行,硬件后配的选型逻辑。在方案阶段先梳理业务:是垂类模型预训练、参数微调,还是RAG、Agent推理服务,再匹配勤龙系列算力硬件。针对企业本地化微调、推理场景,勤龙液冷AI工作站,无需改造专业机房,分体式液冷保障长时间满负载不降频,兼顾高显存与稳定吞吐;大规模集群场景,勤龙GPU服务器配套全栈软硬件调优,释放真实有效算力。
给企业CIO三点选型建议:
1.选型第一步,先明确业务负载,不要盲目追求最高FP8算力;
2.评估硬件清单,优先核验HBM容量、带宽、互联规格;
3.算力方案必须包含软件栈调优预算,硬件只是底座,算子、分布式框架、调度优化决定最终利用率。
算力采购,买的不是芯片参数,是业务稳定运行的有效算力。跳出纸面数字陷阱,才能避免巨额投入变成闲置硬件。
算力选型不能只看芯片宣传参数,业务负载、HBM 规格、卡间互联共同决定最终业务性能。舜源科技勤龙算力服务器,坚持负载先行的方案设计思路,为企业提供软硬件一体化算力底座方案。如需垂类模型微调、推理集群的算力方案评估,欢迎后台留言交流。
舜源科技
IT基础架构及企业级认知平台提供商
上海舜源计算机科技股份有限公司(简称:舜源科技)成立于2008年,是国内领先的AI基础架构及企业级认知平台提供商、高新技术企业。公司深耕政企数字化转型十余年,聚焦认知智能、自主可控、场景落地,以自研认知平台为核心,融合国产化算力底座与安全体系,为政企客户提供 “认知驱动、软硬一体、安全可控” 的数智化解决方案。
依托深厚的行业积累与技术沉淀,舜源科技构建了企业级认知平台、国产化算力基础设施、信息安全防护、全周期技术服务四大核心能力并广泛应用于政府、医疗、教育、能源、制造、交通、零售、科技等各行业。舜源科技服务诸多头部客户,客户粘性高、持续创新能力强,为各行业数智化升级提供坚实支撑。
咨询专线:4008-5050-26
本文来源:舜源科技微信公众号,点击查看原文。